Python tarfile 추출 실패, 남은 파일을 후속 작업에 넘기지 않는 법
tarfile 압축 해제는 오류로 끝났는데 폴더에는 CSV 파일이 이미 생겨 있다. 다음 집계 작업이 이 반쪽짜리 자료를 읽지 않게 하려면 어디서 막아야 할까?
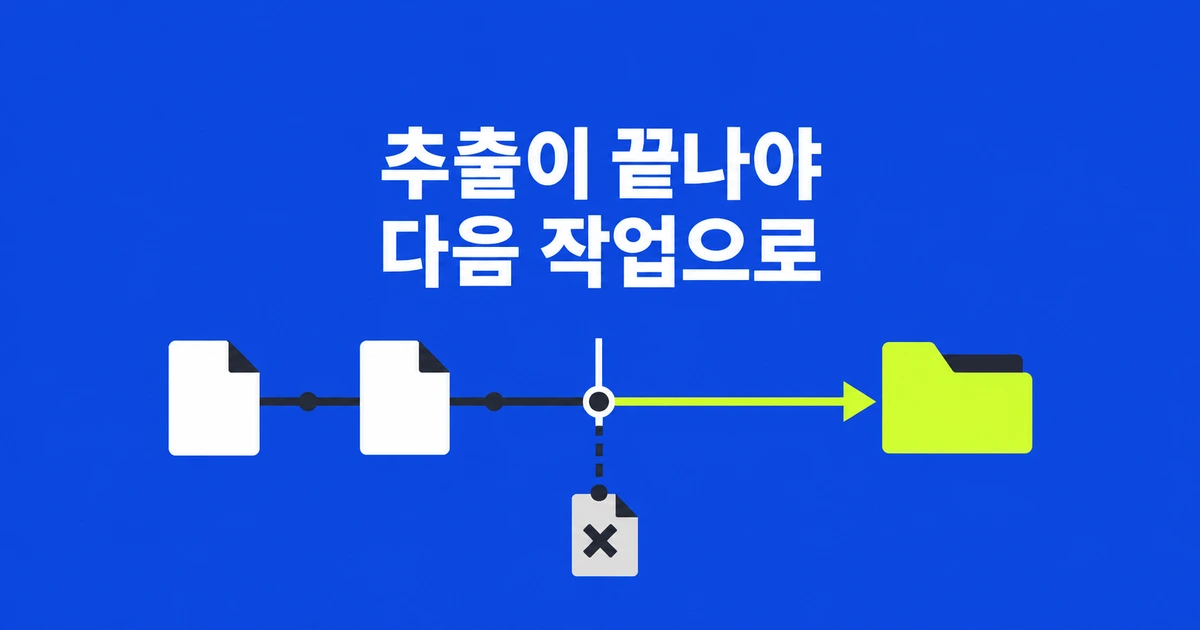
자동으로 받은 tar 자료를 풀다가 오류가 났는데 CSV 파일은 이미 생겨 있을 수 있다. 다음 작업이 ‘파일이 있으면 읽는다’는 조건으로 움직이면 실패한 묶음의 일부를 정상 자료처럼 집계하게 된다. 추출 대상이 처음부터 최종 입력 폴더였기 때문에 생기는 문제다. 작업별 임시 폴더에서 추출과 내용 검사를 끝내고, 통과한 디렉터리에만 최종 이름을 붙이면 후속 작업에 넘기는 시점을 명확히 정할 수 있다.
실제 라이브러리도 이 정리 책임을 따로 다룬다. FastEmbed의 모델 관리 코드에서 압축 파일을 캐시에 푸는 함수는, 실패 시 캐시 전체를 지우지 않는다고 설명한다. 같은 캐시에 다른 자료가 들어 있을 수 있어 부분 추출 정리는 호출자가 맡는다. 작업마다 삭제할 수 있는 폴더를 따로 만들면 이처럼 다른 자료가 섞인 캐시 전체를 정리할 필요가 없다. FastEmbed의 캐시 추출 코드
위험한 항목을 거부해도 먼저 쓴 파일은 남는다
tarfile은 아카이브 항목을 순서대로 추출한다. 첫 항목이 정상 CSV이면 파일을 쓰고, 뒤쪽 링크에서 필터 오류가 발생하면 그 지점에서 중단할 수 있다. 이때 이미 쓴 CSV를 자동으로 되돌리는 트랜잭션은 수행하지 않는다. Python 공식 문서도 예외 뒤에 부분 추출물이 남을 수 있으며 정리는 호출자 책임이라고 설명한다. tarfile 추출 필터
Python 3.14부터 기본인 data 필터는 절대 경로나 추출 위치 밖을 가리키는 링크 등 일부 위험한 동작을 거부한다. 하지만 그 필터가 자료 묶음에 필요한 파일이 다 들어 있는지까지 알 수는 없다. 필터를 통과한 CSV 한 개가 완전한 납품물인지, 설명용 JSON도 있어야 하는지는 그 파일을 사용하는 업무의 규약이다. 필터에 의한 추출 허용과 업무에 넘길 데이터의 완결성 검사가 함께 필요한 이유다.
기자의 재현에서는 rows.csv, manifest.json, 바깥 절대 경로를 가리키는 링크 순서로 tar를 만들었다. data 필터를 써서 대상 폴더에 직접 풀면 링크에서 AbsoluteLinkError가 발생했고 앞의 두 파일은 남았다. 파일 수가 두 개라는 검사만으로도 이 실패를 놓칠 수 있다. 뒤의 링크를 처리하는 단계에서 예외가 발생했으므로, 정상 파일이 보인다는 이유로 오류를 무시하고 다음 작업을 실행하면 안 된다.
이번 예제가 받는 자료 묶음
예제는 정해진 생산자가 보내는 작은 업무 자료를 대상으로 한다. 입력은 다운로드가 끝난 비압축 .tar 파일이며 크기는 1MiB 이하다. 내부에는 최상위의 일반 파일 manifest.json과 rows.csv만 허용하고, 두 파일의 선언된 크기 합계도 1MiB 이하로 제한한다. 폴더, 링크, 중복 이름, 예상하지 않은 파일은 받지 않는다. CSV 데이터는 1~1000행으로 한정한다. 이 수치는 Python의 기본 제한이 아니라 예제에서 정한 입력 규약이다.
rows.csv에는 품목 식별자와 수량이 들어간다. 다음 두 행을 정상 예제로 사용한다. 식별자는 비어 있거나 중복될 수 없고 수량은 0 이상의 정수다. manifest.json의 row_count는 CSV 머리글을 제외한 데이터 행 수를 나타낸다. 수량 합계는 실제로 읽은 CSV에서 계산하므로, 아래 묶음이 통과하면 2행과 합계 46을 얻는다.
rows.csv
item_id,units
A01,12
B02,34

manifest.json
{"row_count": 2}
JSON을 같이 받는 목적은 생산자가 의도한 행 수와 실제 파일의 행 수를 대조하기 위해서다. 공격자가 CSV와 JSON을 모두 바꾸면 이 검사만으로 출처를 증명할 수는 없다. 이 예제는 알려진 생산자와 합의한 형식을 검증하는 단계이며, 익명의 대용량 업로드를 받는 서비스로 범위를 넓히지 않는다. 보고서가 실제 업무 데이터와 맞는지 확인하는 검증도 행 수 검사와 별도로 붙일 수 있다.
압축 형식은 비압축 tar로 고정했다. .tar.gz를 받는 경우에는 압축 해제 후 크기와 압축 스트림의 끝부분 검사까지 설계가 달라진다. 여기서는 파일 크기를 제한한 고정 형식으로 추출·검증·인계 순서를 완결한다. 큰 모델 파일을 받는 FastEmbed 사례에서 정리 책임이라는 질문을 가져왔지만, 그 캐시 규모와 형식을 이 작은 CSV 예제에 그대로 적용하지는 않는다.
추출과 검증을 끝낸 폴더만 인계하기
아래 코드는 Python 3.14의 표준 라이브러리만 사용한다. destination의 부모 폴더는 이미 존재하고 이 작업이 관리하는 위치여야 하며, 같은 목적지를 쓰는 프로세스는 하나라고 가정한다. 최종 경로는 실행마다 새 이름을 정한다. 입력 파일도 다운로드가 끝난 뒤 바뀌지 않는 로컬 파일을 사용한다.
from pathlib import Path
from tempfile import TemporaryDirectory
import csv
import json
import tarfile

LIMIT = 1024 * 1024
REQUIRED = {'manifest.json', 'rows.csv'}


def accept_bundle(archive, destination):
    """Small uncompressed .tar, trusted parent, one writer, new destination."""
    archive, destination = Path(archive), Path(destination)
    if destination.exists() or destination.is_symlink():
        raise FileExistsError(destination)
    if archive.stat().st_size > LIMIT:
        raise ValueError('archive exceeds 1 MiB')
    seen, total = set(), 0

    def checked(member, path):
        nonlocal total
        filtered = tarfile.data_filter(member, path)
        if not member.isfile() or member.name not in REQUIRED:
            raise ValueError('unexpected member')
        if member.name in seen:
            raise ValueError('duplicate member')
        total += member.size
        if member.size < 0 or total > LIMIT:
            raise ValueError('payload exceeds 1 MiB')
        seen.add(member.name)
        return filtered

    with TemporaryDirectory(prefix='.extract-', dir=destination.parent) as tmp:
        staged = Path(tmp) / 'payload'
        staged.mkdir()
        with tarfile.open(archive, 'r:') as bundle:
            bundle.errorlevel = 2
            bundle.extractall(staged, filter=checked)
        if seen != REQUIRED:
            raise ValueError('required file missing')
        manifest = json.loads((staged / 'manifest.json').read_text(encoding='utf-8'))
        if not isinstance(manifest, dict):
            raise ValueError('manifest must be an object')
        count = manifest.get('row_count')
        if type(count) is not int or not 1 <= count <= 1000:
            raise ValueError('row_count must be 1..1000')
        rows, units, ids = 0, 0, set()
        with (staged / 'rows.csv').open(encoding='utf-8', newline='') as f:
            reader = csv.DictReader(f)
            if reader.fieldnames != ['item_id', 'units']:
                raise ValueError('CSV columns must be item_id,units')
            for row in reader:
                if None in row or not row['item_id'] or row['item_id'] in ids:
                    raise ValueError('invalid or duplicate item_id')
                value = row['units']
                if value is None or not value.isascii() or not value.isdecimal():
                    raise ValueError('units must be nonnegative integers')
                ids.add(row['item_id'])
                units += int(value)
                rows += 1
                if rows > 1000:
                    raise ValueError('too many rows')
        if rows != count:
            raise ValueError('row count mismatch')
        staged.rename(destination)
    return {'rows': rows, 'units': units}
checked 함수는 먼저 기본 data_filter를 호출해 해당 항목의 추출 가능 여부를 검사한다. 그다음 이 업무에서 허용하는 파일명과 일반 파일 여부를 검사한다. 같은 이름이 두 번 나오면 앞의 내용을 뒤 항목이 덮어쓸 수 있으므로 중복도 오류로 처리한다. 크기 합계는 파일을 쓰기 전에 더하고, 한도를 넘으면 그 항목을 추출하기 전에 예외를 낸다. 이런 용도의 사용자 필터는 PEP 706이 설명하는 확장 방식이다. PEP 706
errorlevel을 2로 지정하면 tarfile의 비치명적 추출 오류도 예외로 처리한다. 이 흐름에서는 오류가 난 항목을 건너뛴 채 남은 파일만 성공으로 취급하지 않는다. checked에서 낸 ValueError 역시 밖으로 전달되므로, 호출자는 실패한 실행을 알아낼 수 있다. 필터 오류를 잡은 다음에도 성공 경로를 계속 실행하는 코드를 덧붙이면 이 설계의 효과가 사라진다.
추출이 끝나면 seen에 기록한 파일명이 필수 목록과 정확히 같은지 검사한다. 이어 JSON의 row_count가 정수이며 1~1000인지 확인하고, CSV 열 이름과 순서를 item_id,units로 고정한다. 각 행의 식별자 중복, 빠진 수량, 정수가 아닌 수량, 여분의 필드도 거부한다. 마지막으로 실제 행 수를 JSON 값과 대조한다. 필수 파일만 존재하고 내용은 비어 있거나 다른 형식인 상황을 이 단계에서 걸러낸다.
모든 검사를 통과해야 staged.rename(destination)이 실행된다. 임시 디렉터리를 destination의 부모 아래에 만들었기 때문에 이 예제의 이동은 같은 파일시스템 안에서 이뤄진다. 후속 작업은 .extract-로 시작하는 임시 경로를 읽지 않고 최종 destination만 사용한다. 따라서 추출 도중이나 검사 도중에는 최종 입력 경로가 나타나지 않는다. Path.rename
예외가 발생하면 TemporaryDirectory의 with 블록을 벗어나면서 해당 실행의 임시 폴더를 정리한다. 성공 시에는 payload 폴더를 밖으로 옮겼으므로 빈 임시 바깥 폴더만 정리된다. 다른 실행이 이미 만든 결과나 공유 캐시 전체를 지우지 않아도 되는 이유다. 이 정리 동작은 정상적인 코드 종료와 예외 전파에 관한 것이며, 강제 종료나 전원 중단 뒤의 복구 절차까지 대신하지 않는다. TemporaryDirectory
정상·거부 링크·필수 파일 누락의 실제 결과
Python 3.14.4에서 같은 입력 생성 규칙으로 자료 묶음을 만들고 위 함수를 실행했다. 정상 묶음에는 앞서 제시한 두 파일이 있다. 거부 링크 묶음에는 두 파일 뒤에 절대 경로 링크를 추가했고, 누락 묶음에는 CSV만 넣었다. 각 묶음에 같은 파일명·행 규약을 적용하고 최종 폴더의 존재 여부를 기록했다.
| 입력 | 관찰한 동작 | 최종 폴더 |
|---|---|---|
| 정상 파일 두 개다. | 2행·수량 합계 46을 반환했다. | 두 파일을 담아 생성됐다. |
| 정상 파일 뒤에 절대 경로 링크가 있다. | AbsoluteLinkError로 중단했다. | 생성되지 않았다. |
| manifest.json이 없다. | required file missing 오류를 냈다. | 생성되지 않았다. |
| JSON은 3행, 실제 CSV는 2행이다. | row count mismatch 오류를 냈다. | 생성되지 않았다. |
| rows.csv를 두 번 넣었다. | duplicate member 오류를 냈다. | 생성되지 않았다. |
| CSV 첫 열이 item_id 대신 item이다. | 열 이름 검사에서 중단했다. | 생성되지 않았다. |
크기 제한도 따로 확인했다. 입력 파일 자체가 1MiB를 넘으면 임시 폴더를 만들기 전에 거부했다. 작은 tar 헤더가 펼칠 파일 크기를 1MiB 초과로 선언한 경우에는 사용자 필터가 중단했다. 각 실패 뒤에는 해당 실행의 임시 폴더가 남지 않았다. 기존 목적지에 keep.txt를 둔 경우에는 FileExistsError가 발생했고 기존 파일 내용은 보존됐다.
직접 추출에서는 링크 오류가 난 뒤에도 최종 폴더에 두 파일이 남았다. 임시 폴더 방식에서는 같은 오류가 발생해도 최종 폴더는 만들어지지 않았고, 앞서 쓴 두 파일은 임시 폴더와 함께 정리됐다. 후속 집계가 최종 경로만 읽도록 연결하면 이 실패한 묶음을 입력으로 받지 않는다.
후속 집계는 함수 성공 뒤에 시작한다
정상 예제를 직접 만들려면 sample 폴더에 앞서 제시한 rows.csv와 manifest.json을 저장한다. 함수 코드를 저장한 bundle_gate.py의 마지막에는 다음 호출을 추가한다.
print(accept_bundle("incoming/report.tar", "accepted/report-20261026-01"))sample과 bundle_gate.py가 있는 위치에서 아래 명령을 실행한다. 두 파일을 직접 지정해 tar 안에 불필요한 폴더 항목이 들어가지 않도록 구성한다.
mkdir -p incoming accepted
tar -cf incoming/report.tar -C sample rows.csv manifest.json
python3 bundle_gate.py
터미널에는 rows 2, units 46을 담은 반환값이 출력된다. 기존 프로그램에서는 accept_bundle 함수를 불러와 반환값을 받아 쓰면 된다. 호출이 반환된 다음에만 accepted/report-20261026-01/rows.csv를 보고서 작성이나 집계 작업에 넘긴다.
호출에서 예외가 발생한 실행은 실패로 기록하고 후속 집계를 호출하지 않는다. 필수 파일 누락이나 행 수 불일치라면 생산자에게 완전한 묶음을 다시 받는다. 같은 불완전한 파일을 반복해 풀어도 내용 검사를 통과하지는 않는다. 네트워크 재전송으로 새 파일을 받는 경우에도 다운로드를 마친 뒤 다른 실행 이름으로 같은 절차를 적용하면 이전 성공 결과를 덮어쓰지 않는다.
실제 스케줄 작업에 연결할 때는 실행 식별자를 결과 폴더 이름에 넣고, 같은 이름을 쓰는 작업이 중복 실행되지 않도록 구성한다. 이 예제의 존재 검사와 이름 변경 사이에는 다른 프로세스가 끼어들 수 있기 때문이다. 함수가 반환한 뒤 시작하는 보고서 작성·이메일 전송·데이터베이스 반영은 각 단계의 결과를 별도로 기록한다. 파일 인계에 성공한 실행이라도 이후 전송은 실패할 수 있다.